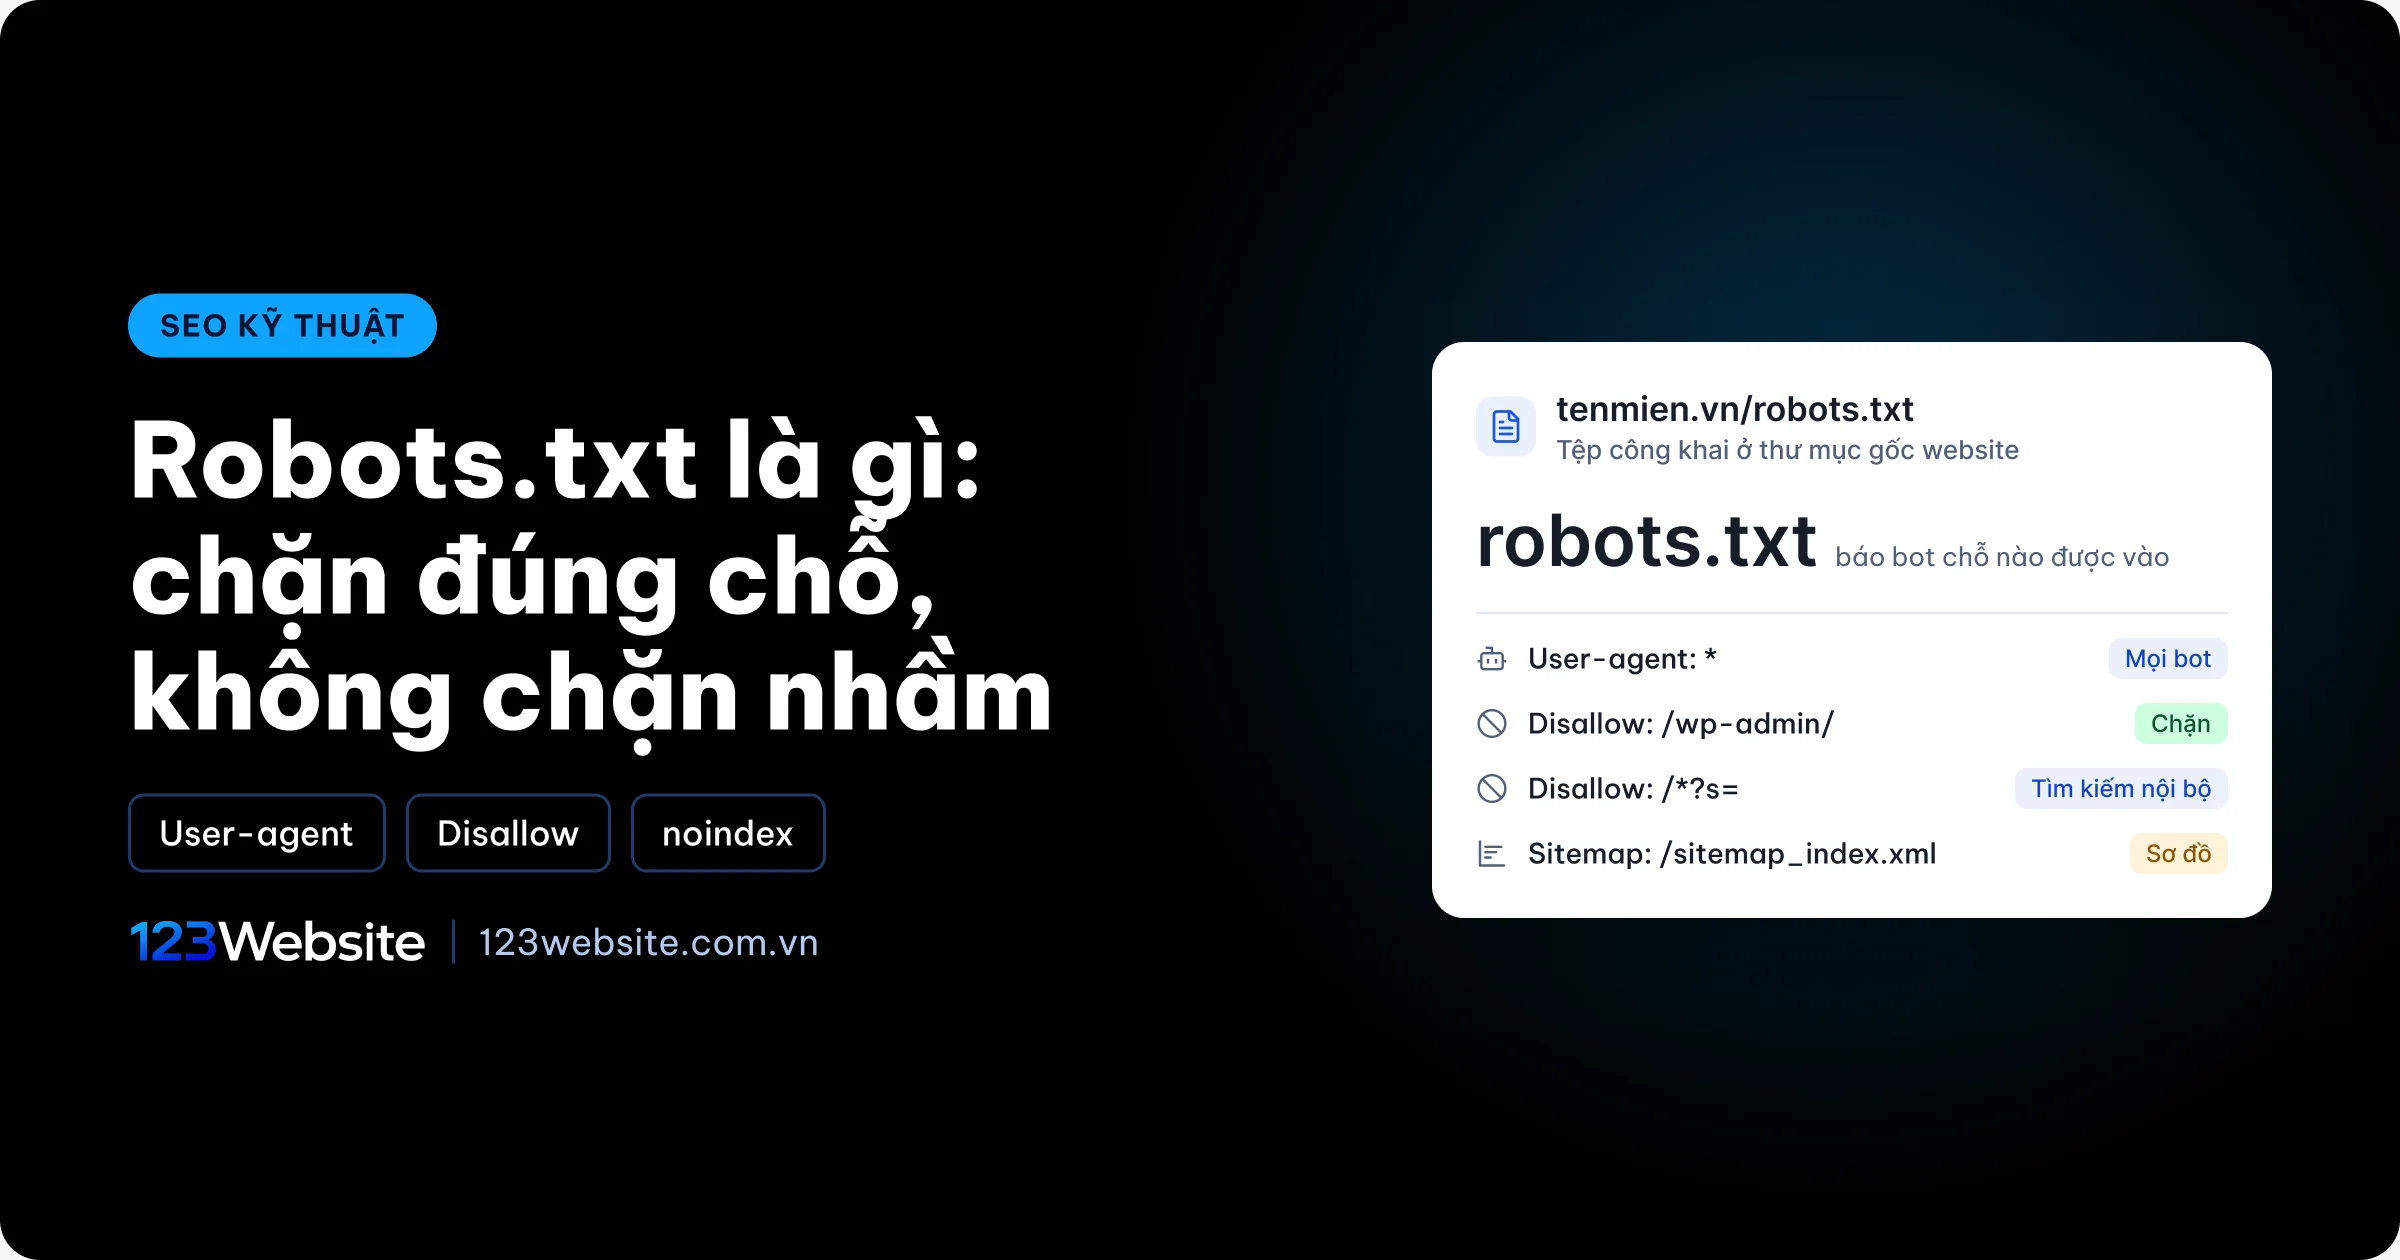
Website mới ra mắt cả tháng mà gõ tên công ty lên Google vẫn không thấy, hoặc ngược lại, trang cảm ơn sau khi gửi form lại hiện ngay trên kết quả tìm kiếm. Cả hai chuyện thường quy về hai thứ nhỏ: tệp robots.txt và thẻ noindex. Bài này giải thích robots.txt là gì, noindex là gì, hai thứ khác nhau ra sao và cách dùng đúng trên website WordPress.
Tóm tắt nhanh
- Robots.txt là tệp ở thư mục gốc, báo cho bot của công cụ tìm kiếm chỗ nào được thu thập, chỗ nào không. Nó không giấu được trang khỏi Google.
- Noindex là thẻ báo Google không đưa trang vào kết quả tìm kiếm. Trang gắn noindex phải để bot vào được, tức là không được chặn trong robots.txt.
- Trên WordPress, sửa robots.txt và gắn noindex bằng plugin SEO, rồi kiểm tra trong Search Console bằng báo cáo robots.txt và công cụ Kiểm tra URL.
Robots.txt là gì?
Robots.txt là một tệp văn bản thuần đặt ở thư mục gốc của website, dùng để báo cho trình thu thập dữ liệu (bot) của công cụ tìm kiếm biết được phép truy cập những đường dẫn nào. Theo tài liệu của Google, tệp này chủ yếu để tránh bot gửi quá nhiều yêu cầu tới máy chủ và bỏ qua những khu vực không cần thu thập, chứ không phải cơ chế ẩn trang.
Có thể hình dung robots.txt như tấm biển dán ở cổng: “khu kho, khu văn phòng xin miễn vào”. Bot của Google, Bing và phần lớn công cụ tìm kiếm uy tín đọc tấm biển này trước khi đi tiếp. Tuy vậy, đây chỉ là lời đề nghị, bot xấu hay công cụ cào dữ liệu có thể phớt lờ, vì vậy đừng coi nó là lớp bảo mật.
File robots.txt nằm ở đâu và áp dụng cho phạm vi nào?
File robots.txt phải nằm ngay thư mục gốc, ví dụ tenmien.vn/robots.txt; đặt trong thư mục con thì bot không đọc. Mỗi tên miền, mỗi tên miền con và mỗi giao thức có tệp riêng, nên tệp của tenmien.vn không áp dụng cho shop.tenmien.vn. Muốn xem robots.txt của bất kỳ website nào, bạn chỉ cần gõ thêm /robots.txt sau tên miền, vì tệp này luôn công khai.
Chính vì công khai, đừng liệt kê đường dẫn trang quản trị riêng hay tài liệu nội bộ vào robots.txt với ý định giấu đi. Làm vậy chẳng khác nào chỉ đường cho người tò mò. Những gì thật sự riêng tư cần được bảo vệ bằng mật khẩu.
Robots.txt hoạt động thế nào với Googlebot?
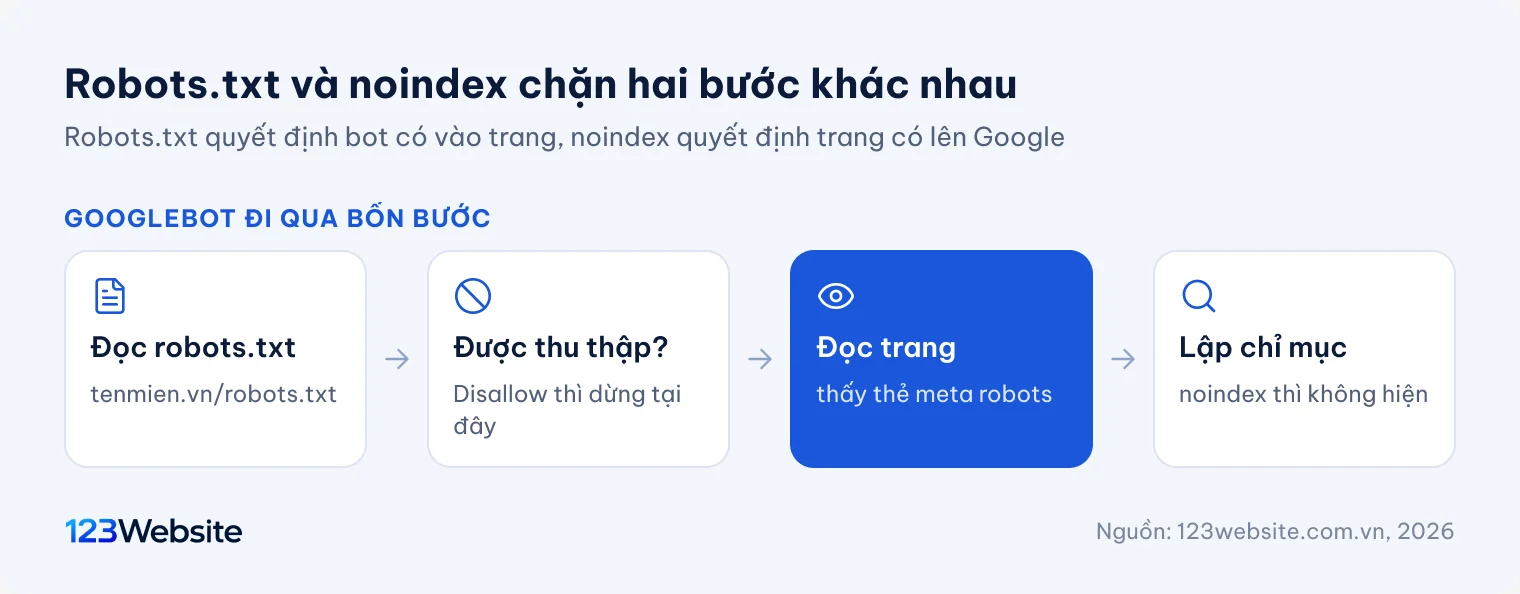
Trước khi thu thập một trang, Googlebot tải robots.txt của tên miền đó và đối chiếu đường dẫn trang với các lệnh trong tệp. Đường dẫn bị chặn thì bot dừng ở đó, không tải nội dung trang. Đường dẫn được phép thì bot tải trang, đọc nội dung, các thẻ meta và đi tiếp theo các liên kết.
Google thường lưu robots.txt trong bộ nhớ đệm tối đa 24 giờ, nên sửa xong có thể mất khoảng một ngày mới có tác dụng. Cách Google xử lý khi không tải được tệp cũng đáng biết: tệp trả lỗi 404 thì Google coi như không có giới hạn nào; còn lỗi máy chủ 5xx thì Google tạm ngừng thu thập trong 12 giờ đầu và dùng bản tải được gần nhất trong 30 ngày tiếp theo. Hosting chập chờn đúng lúc bot ghé vì vậy có thể làm việc thu thập cả website chậm lại.
Cấu trúc robots.txt: các lệnh cần biết
Cấu trúc robots.txt gồm các nhóm lệnh, mỗi nhóm mở đầu bằng dòng User-agent cho biết nhóm áp dụng cho bot nào, rồi tới các dòng Disallow, Allow. Dòng Sitemap đứng riêng và áp dụng chung cho mọi bot. Bảng dưới đây là bốn lệnh bạn sẽ gặp trong hầu hết tệp robots.txt.
| Lệnh | Ý nghĩa | Ví dụ |
|---|---|---|
| User-agent | Nhóm lệnh áp dụng cho bot nào; dấu * là mọi bot | User-agent: * |
| Disallow | Đường dẫn không cho thu thập | Disallow: /wp-admin/ |
| Allow | Mở lại một đường dẫn nằm trong vùng bị chặn | Allow: /wp-admin/admin-ajax.php |
| Sitemap | Địa chỉ đầy đủ của sơ đồ trang web, có cả https | Sitemap: https://tenmien.vn/sitemap_index.xml |
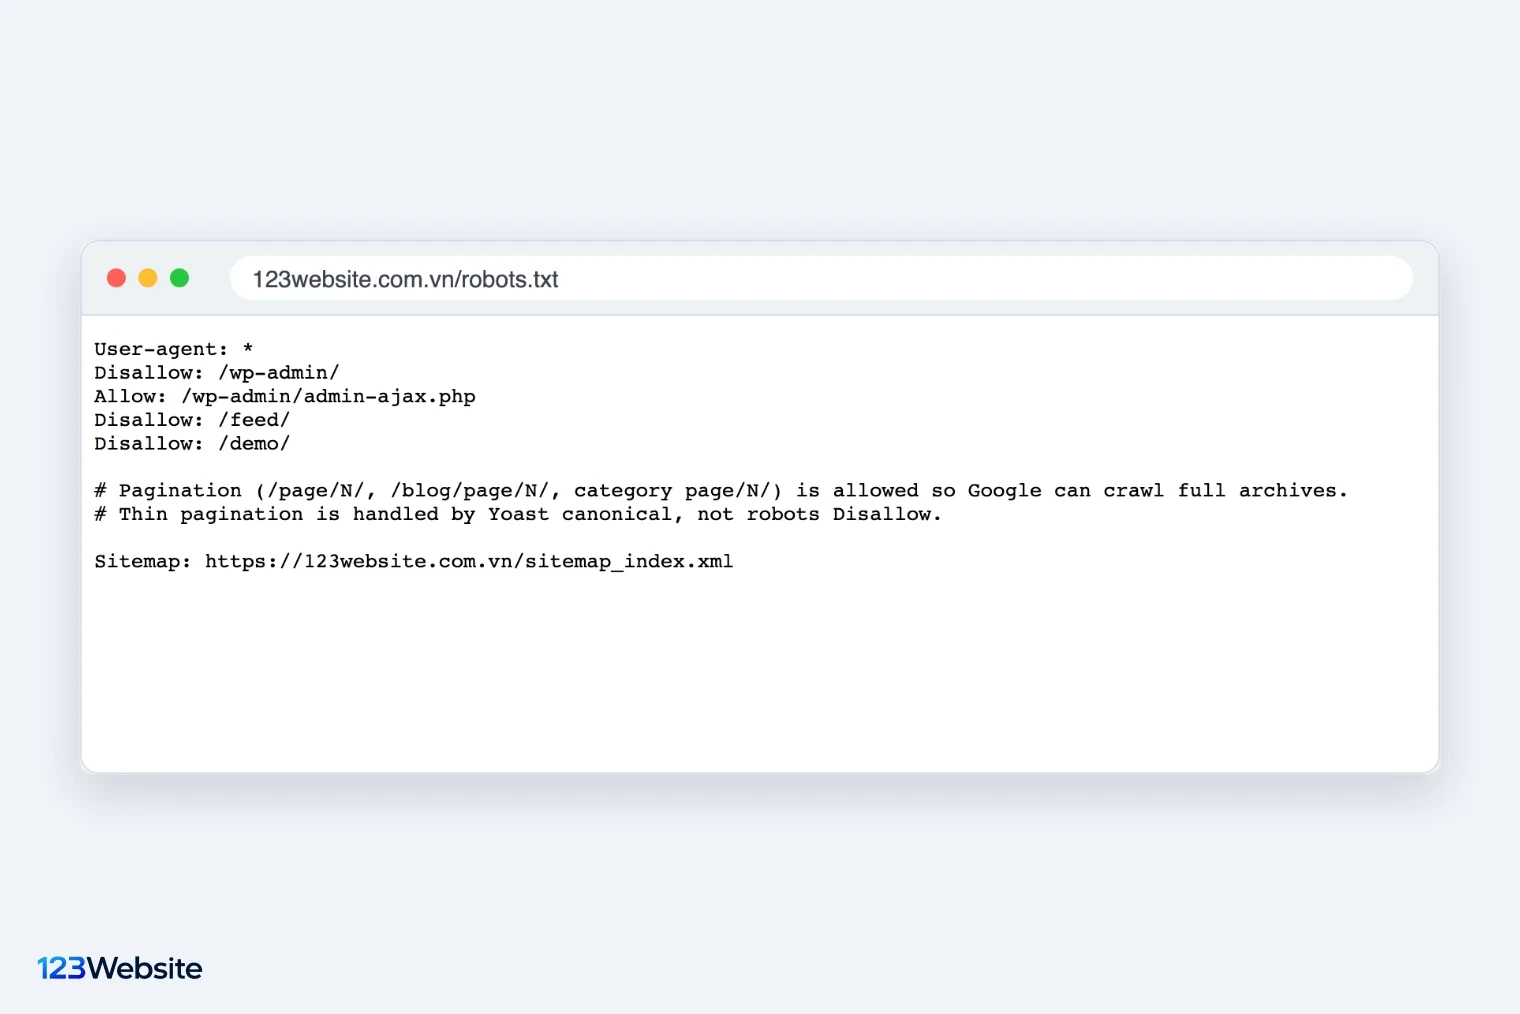
Theo quy cách robots.txt của Google, tệp phải là văn bản thuần mã hoá UTF-8 và phần vượt quá 500 KiB bị bỏ qua. Dòng bắt đầu bằng dấu # là ghi chú, bot không đọc. Google không hỗ trợ lệnh crawl-delay, nên thêm lệnh này để giảm tải cho Googlebot là vô ích.
User-agent và Disallow viết sao cho đúng?
User-agent là tên bot mà nhóm lệnh nhắm tới, như Googlebot, Bingbot, hoặc dấu * cho mọi bot. Một bot chỉ theo nhóm có tên mình cụ thể nhất; nếu có nhóm riêng cho Googlebot thì Googlebot bỏ qua nhóm *. Vì vậy, khi tách nhóm riêng, bạn phải chép lại đủ các lệnh cần thiết vào nhóm đó, không phải chỉ ghi phần khác biệt.
Disallow nhận một đường dẫn tính từ gốc website. Disallow: / chặn toàn bộ website, còn Disallow: để trống nghĩa là không chặn gì; chỉ khác nhau một dấu gạch chéo nhưng kết quả trái ngược hẳn. Đường dẫn phân biệt chữ hoa, chữ thường, nên /Admin/ và /admin/ là hai đường khác nhau. Khi Allow và Disallow cùng khớp một đường dẫn, Google chọn quy tắc có đường dẫn dài hơn, tức là cụ thể hơn.
Ký tự đại diện * và $
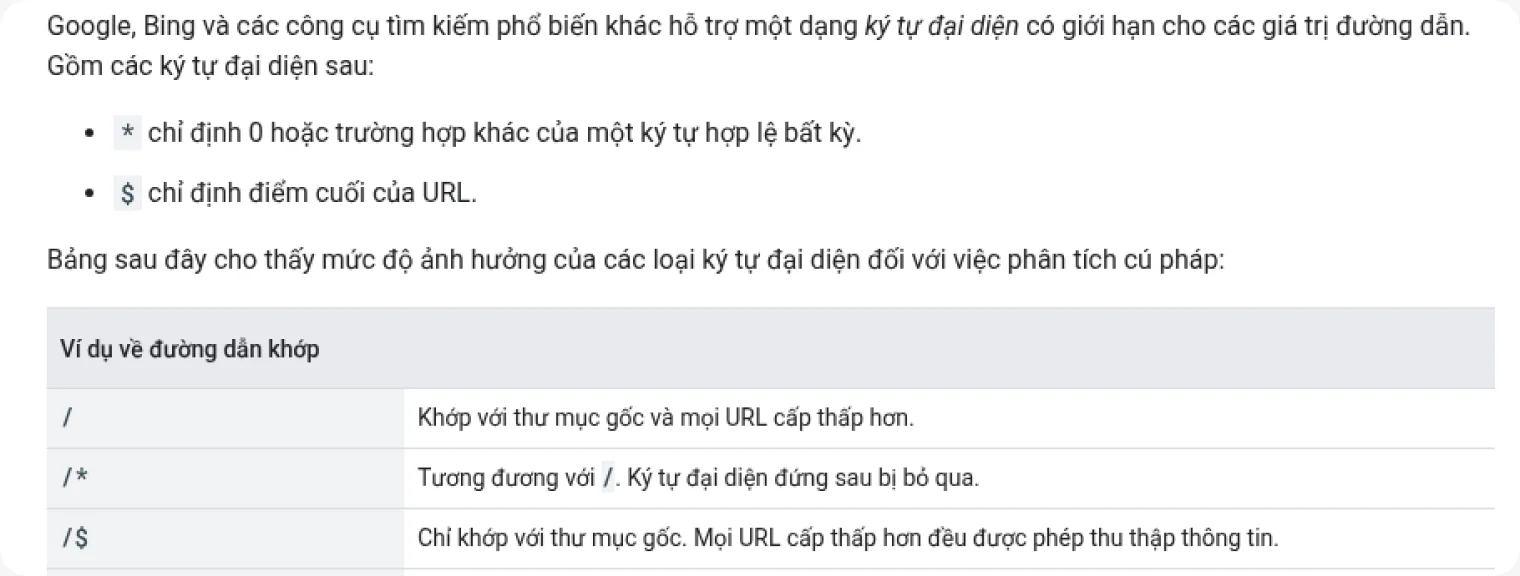
Google và Bing hỗ trợ hai ký tự đại diện trong đường dẫn: dấu * thay cho một chuỗi ký tự bất kỳ, dấu $ đánh dấu điểm kết thúc của địa chỉ. Ví dụ Disallow: /?s= chặn mọi trang kết quả tìm kiếm nội bộ của WordPress, còn Disallow: /.pdf$ chặn mọi tệp PDF. Dùng ký tự đại diện tiện nhưng dễ chặn rộng hơn ý muốn, nên sau khi viết, bạn hãy thử vài đường dẫn thật để chắc chỉ những trang cần chặn bị ảnh hưởng.
Noindex là gì?
Noindex là quy tắc báo cho công cụ tìm kiếm không đưa một trang vào kết quả tìm kiếm. Khác với robots.txt nằm ở một tệp riêng, noindex gắn trên từng trang. Theo hướng dẫn noindex của Google, khi thu thập trang và thấy quy tắc này, Google loại hẳn trang khỏi kết quả, kể cả khi trang khác có liên kết tới.
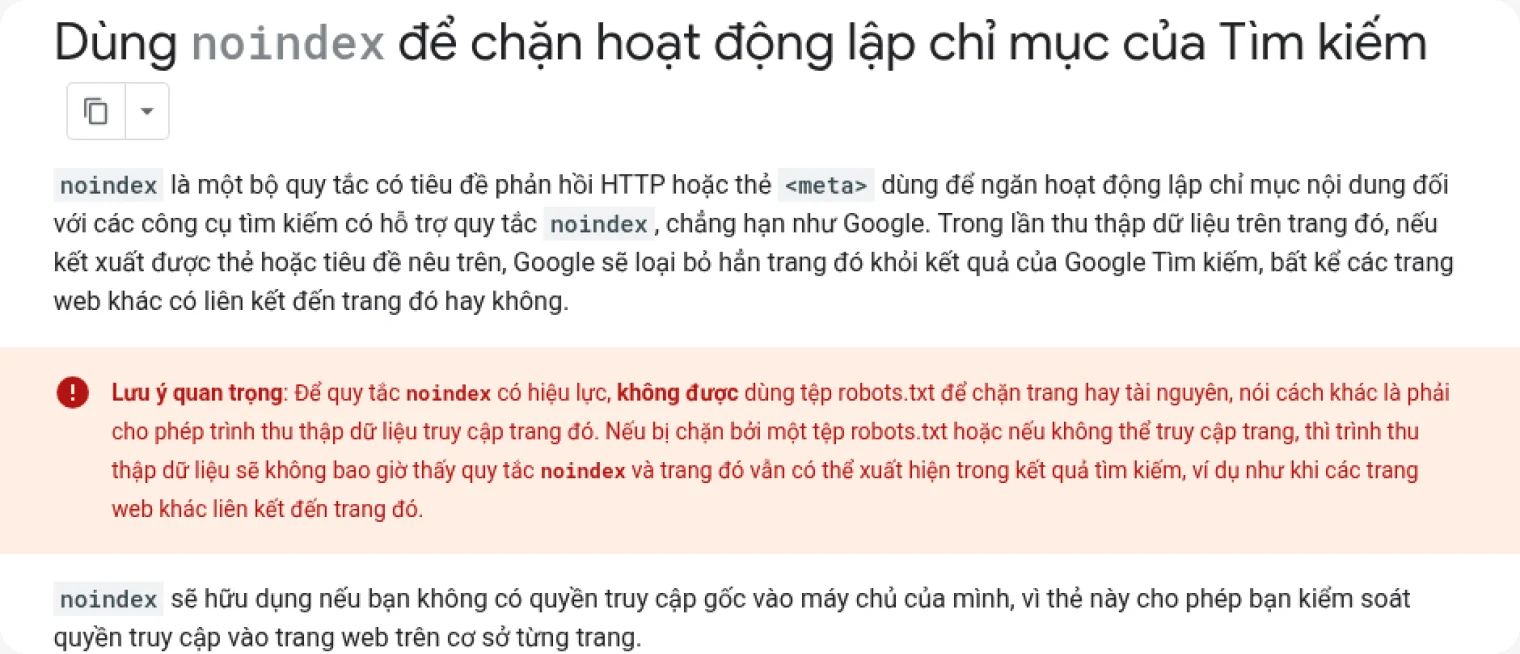
Noindex hợp với những trang cần có cho khách đang ở trên website nhưng không có ích gì cho người tìm trên Google, như trang cảm ơn sau khi gửi form hay trang tài khoản khách. Trang vẫn mở bình thường, khách vẫn dùng được, chỉ là không hiện khi ai đó tìm trên Google.
Thẻ meta robots và X-Robots-Tag
Có hai cách gắn noindex với hiệu quả như nhau. Cách phổ biến là thẻ meta robots đặt trong phần head của trang HTML, dạng <meta name="robots" content="noindex">. Cách thứ hai là tiêu đề phản hồi HTTP X-Robots-Tag: noindex do máy chủ gửi kèm, dùng cho tệp không phải HTML như PDF hay hình ảnh, nơi không có chỗ đặt thẻ meta.
Google không hỗ trợ ghi noindex trong tệp robots.txt, nên dòng Noindex: trong robots.txt mà bạn có thể thấy ở vài hướng dẫn cũ không còn tác dụng. Các thẻ meta khác như description, viewport được giải thích kỹ hơn trong bài tối ưu thẻ meta.
Robots.txt và noindex khác nhau thế nào?
Robots.txt và noindex hay bị dùng lẫn vì cùng mang chữ “chặn”, nhưng chúng chặn hai việc khác nhau. Robots.txt chặn việc thu thập, tức là bot không được vào đọc trang. Noindex chặn việc hiển thị, tức là bot đọc trang rồi nhưng không đưa lên kết quả tìm kiếm.
| Robots.txt (Disallow) | Noindex | |
|---|---|---|
| Đặt ở đâu | Một tệp ở thư mục gốc | Trên từng trang hoặc tiêu đề HTTP |
| Google có đọc trang | Không | Có, phải đọc được mới thấy noindex |
| Trang có thể vẫn hiện | Có, nếu nơi khác liên kết tới | Không, sau khi Google thu thập lại |
| Dùng khi | Giảm tải thu thập, trang lọc, khu quản trị | Trang cần giữ nhưng không muốn lên Google |
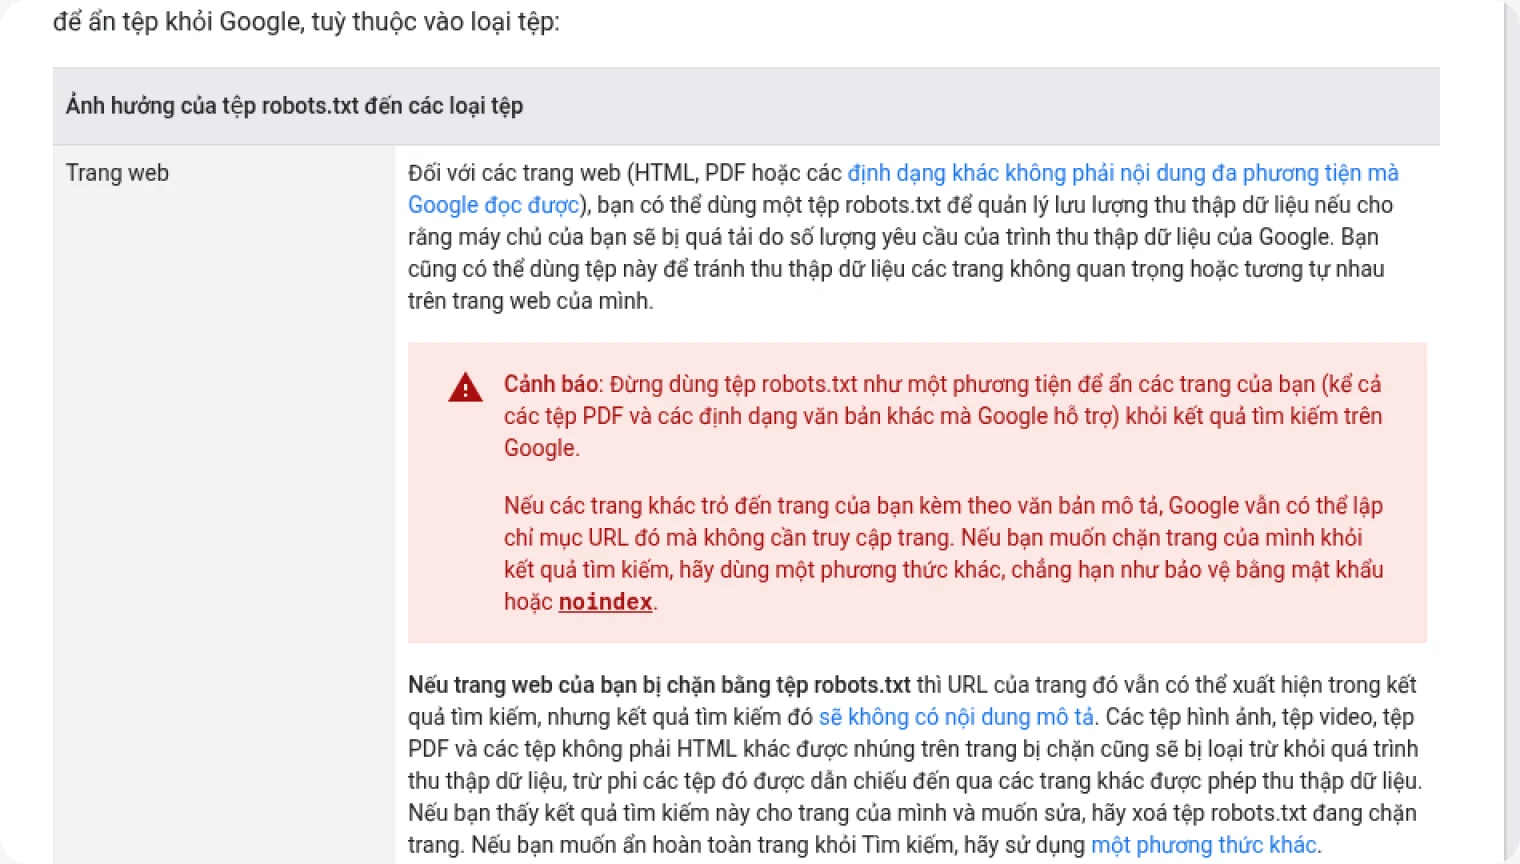
Điểm khác quan trọng nhất nằm ở hàng thứ ba của bảng. Trang bị chặn bằng robots.txt vẫn có thể hiện trên Google nếu website khác liên kết tới, chỉ là kết quả có địa chỉ mà không có mô tả. Trong Search Console, những trang như vậy hiện với trạng thái “Đã lập chỉ mục, mặc dù bị robots.txt chặn”.
Lỗi hay gặp nhất là vừa chặn trong robots.txt vừa gắn noindex cho cùng một trang, với suy nghĩ “chặn hai lớp cho chắc”. Kết quả ngược lại: bot không vào được trang nên không bao giờ thấy thẻ noindex, và trang vẫn có thể nằm trên Google. Muốn trang biến khỏi kết quả, bạn gắn noindex và để robots.txt cho bot vào.
Khi nào nên chặn trang và chặn bằng cách nào?
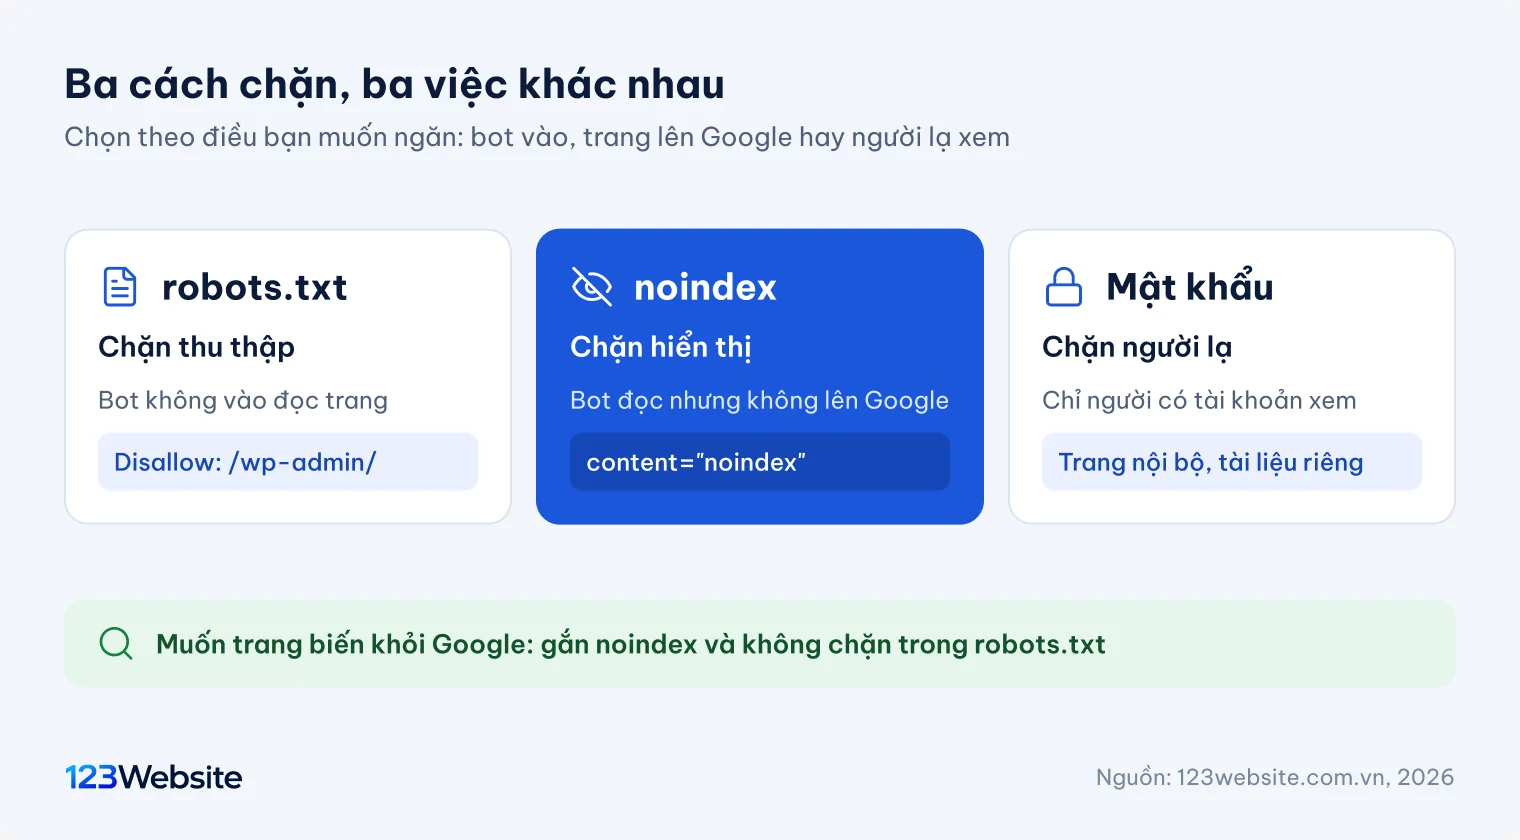
Câu hỏi đúng không phải “có nên chặn không” mà là “muốn ngăn điều gì”. Muốn bot bớt tốn công ở những trang vô hạn biến thể thì dùng robots.txt. Muốn trang không hiện trên Google thì dùng noindex. Muốn người lạ không xem được thì đặt mật khẩu, và trang đã bỏ hẳn thì trả lỗi 404 hoặc chuyển hướng 301 sang trang thay thế.
Trang nên gắn noindex
Những trang sau thường nên gắn noindex trên website doanh nghiệp: trang cảm ơn sau khi gửi form hoặc đặt hàng, trang tìm kiếm nội bộ, trang đăng nhập và tài khoản khách, trang giỏ hàng, thanh toán, trang thử nghiệm công khai, cùng các trang lưu trữ gần như không có nội dung như trang tác giả của website chỉ có một người viết. Ngược lại, đừng bao giờ gắn noindex cho trang dịch vụ, sản phẩm, bài viết mà bạn muốn khách tìm thấy.
Trang chỉ nên chặn thu thập bằng robots.txt
Robots.txt hợp với những khu vực bot không cần vào và có thể sinh ra rất nhiều địa chỉ: khu quản trị /wp-admin/, trang lọc sản phẩm kết hợp nhiều tham số, trang sắp xếp theo giá, theo tên. Với website bán hàng có vài nghìn sản phẩm, các bộ lọc có thể tạo ra số địa chỉ lớn gấp nhiều lần số sản phẩm, và chặn chúng giúp bot dành thời gian cho trang sản phẩm thật.
Một nguyên tắc nữa: không chặn CSS, JavaScript và hình ảnh mà trang cần để hiển thị. Google tải trang như một trình duyệt, thiếu những tệp này thì Google khó hiểu bố cục và có thể đánh giá sai trang trên điện thoại.
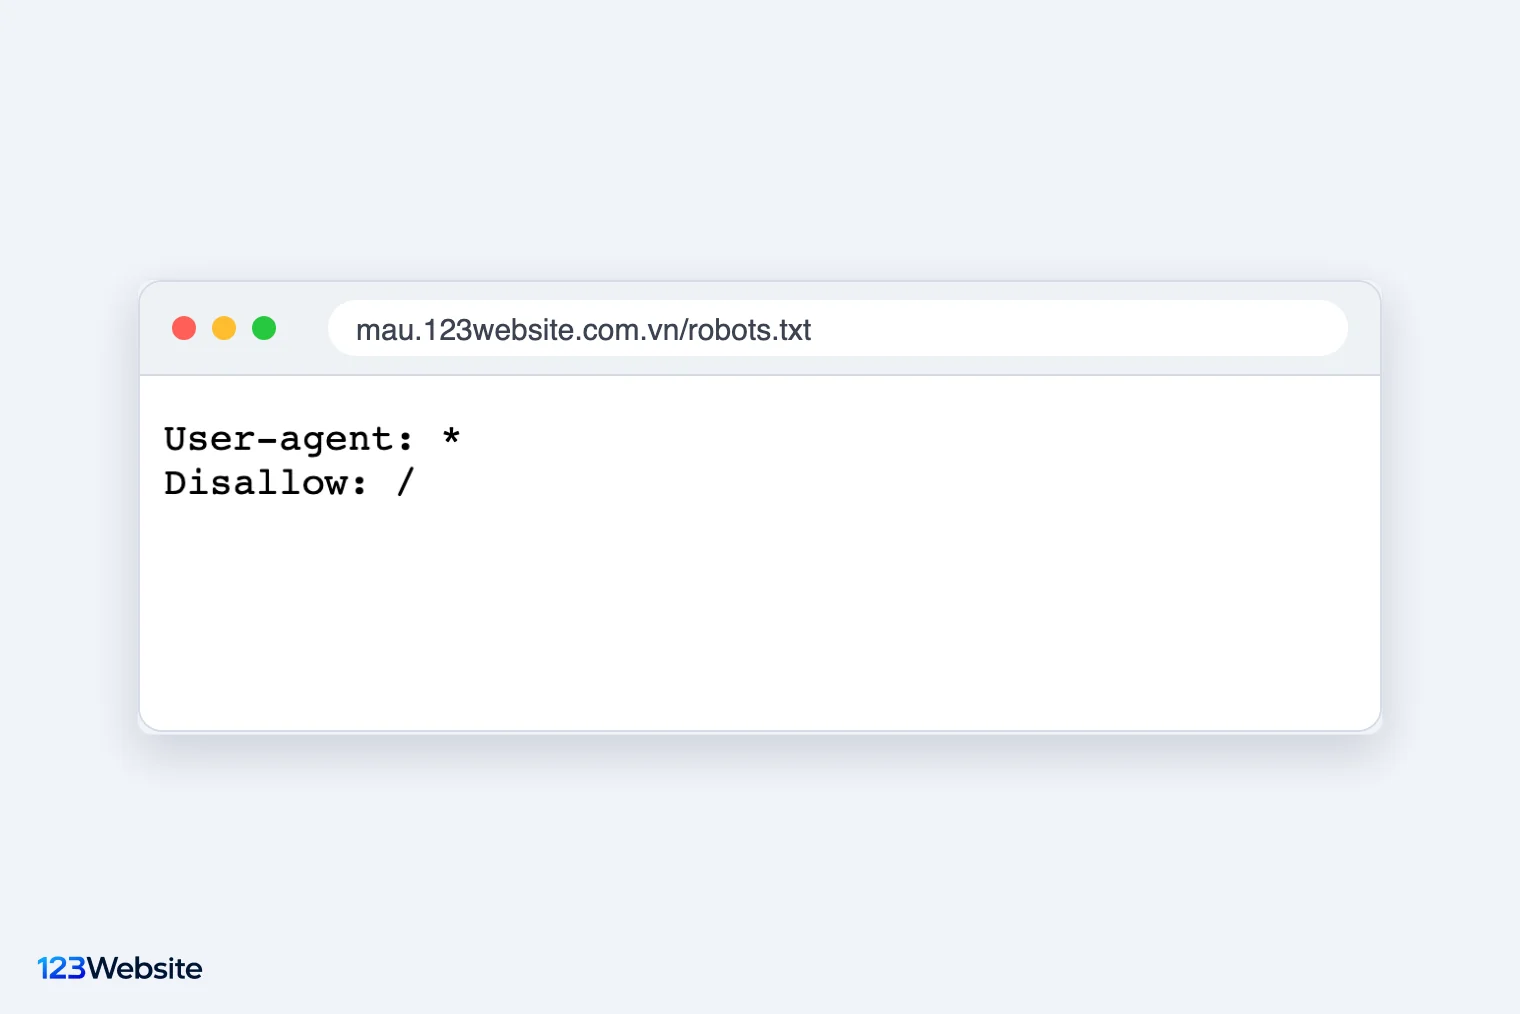
Góc nhìn 123Website: Kho demo mẫu giao diện Việt hoá của 123Website đặt ở tên miền con mau.123website.com.vn, và robots.txt của tên miền con này chặn toàn bộ (Disallow: /), vì đó là các trang trình diễn có nội dung lặp giữa các mẫu, bot không cần tốn công thu thập. Còn robots.txt của website chính thì mở phân trang /page/2/ để Google thu thập đủ bài cũ và có dòng ghi chú giải thích rằng trang mỏng được xử lý bằng thẻ canonical của Yoast chứ không chặn bằng Disallow. Tách vai rõ như vậy giúp người sửa sau đọc tệp là hiểu vì sao từng dòng tồn tại.
Robots.txt WordPress: tạo và sửa thế nào?
Với robots.txt WordPress, bạn có sẵn một tệp ảo: khi thư mục gốc chưa có tệp thật, WordPress tự trả về vài dòng cơ bản chặn /wp-admin/ và mở admin-ajax.php. Muốn chỉnh, có hai cách. Cách thứ nhất là dùng plugin SEO: Yoast SEO có mục Công cụ, Trình chỉnh sửa tập tin để tạo và sửa robots.txt ngay trong trang quản trị, Rank Math cũng có phần tương tự. Cách thứ hai là soạn tệp bằng trình soạn văn bản thuần, lưu UTF-8 rồi tải lên thư mục gốc qua trình quản lý tệp của hosting; tệp thật sẽ thay cho tệp ảo.
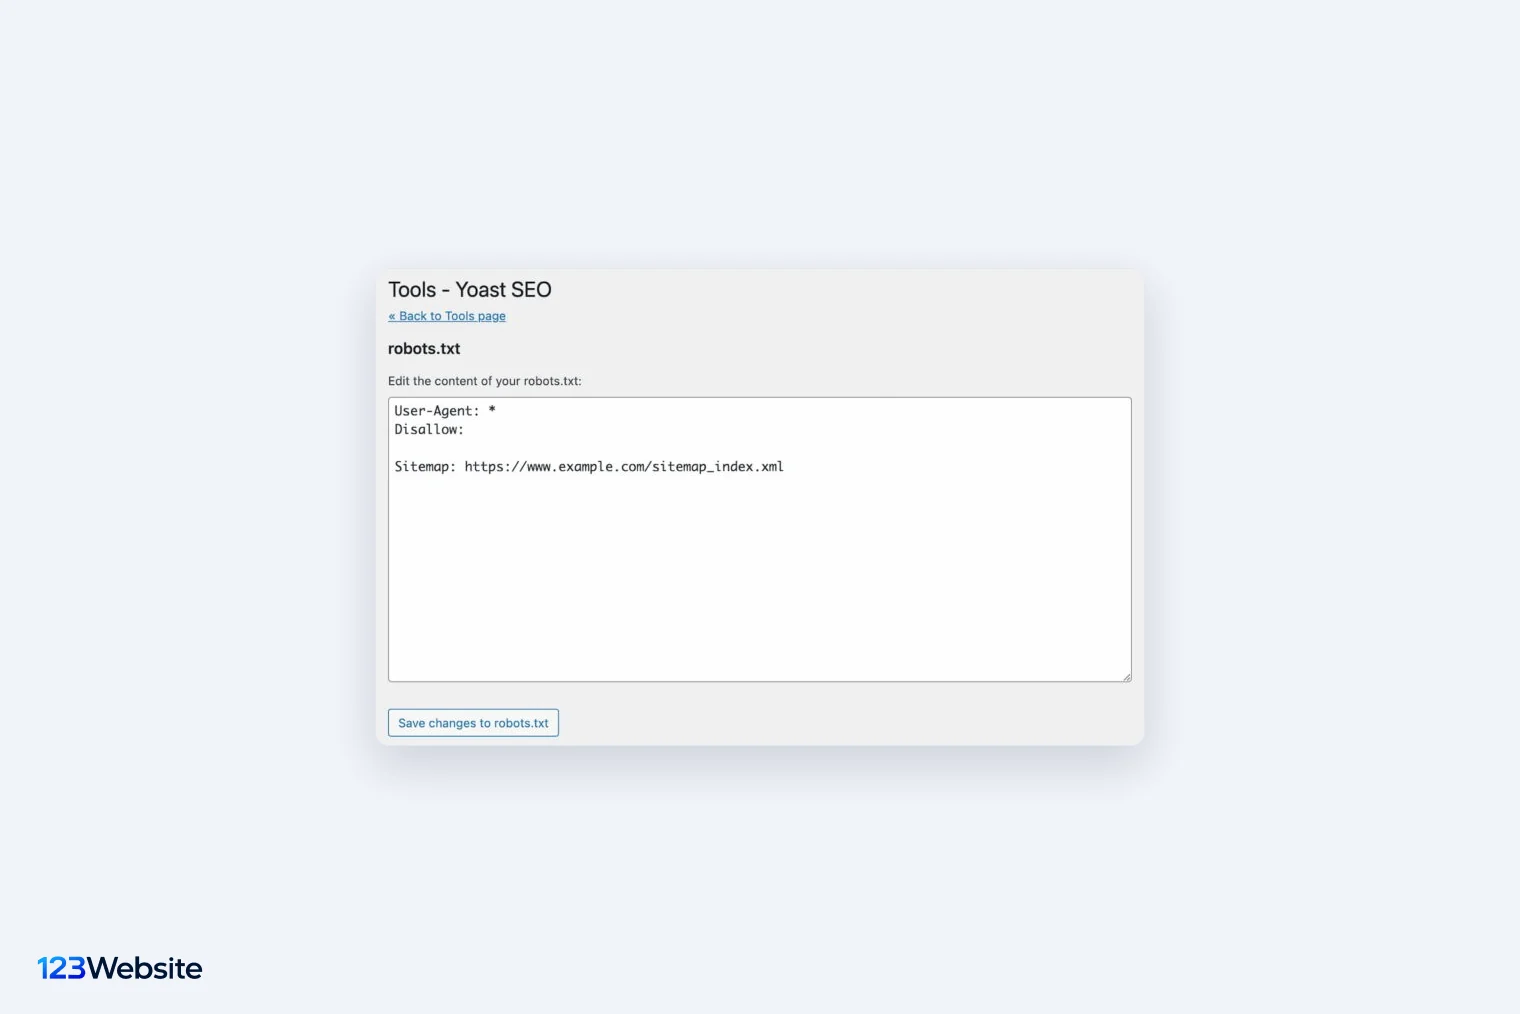
Mẫu robots.txt cho website WordPress
Với phần lớn website doanh nghiệp dùng WordPress và Yoast SEO, một tệp tối giản như dưới đây là đủ. Thay tenmien.vn bằng tên miền của bạn, và nếu dùng plugin SEO khác thì sửa dòng Sitemap theo địa chỉ sơ đồ trang web mà plugin tạo ra.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /*?s=
Sitemap: https://tenmien.vn/sitemap_index.xml
Dòng Disallow: /*?s= chặn trang tìm kiếm nội bộ, nơi bot có thể sinh ra vô số địa chỉ từ những từ khoá ngẫu nhiên. Website bán hàng có thể cần thêm vài dòng cho trang lọc, nhưng hãy thêm dần và kiểm tra từng dòng thay vì chép nguyên một tệp dài từ nơi khác.
Gắn noindex bằng Yoast SEO
Để gắn noindex cho một trang cụ thể, bạn mở trang đó trong trình soạn thảo, kéo xuống khung Yoast SEO, chọn thẻ Nâng cao, rồi ở câu hỏi cho phép công cụ tìm kiếm hiển thị nội dung này trong kết quả tìm kiếm thì chọn Không. Với cả một loại trang như trang lưu trữ tác giả hay trang tệp đính kèm, phần cài đặt chung của Yoast có tuỳ chọn ẩn khỏi kết quả tìm kiếm cho từng loại.
Riêng ô Ngăn chặn các công cụ tìm kiếm đánh chỉ mục website này trong Cài đặt, Đọc cần đặc biệt chú ý. Từ WordPress 5.3, ô này không thêm Disallow vào robots.txt nữa mà gắn noindex cho toàn bộ website. Bật lúc đang dựng là đúng, nhưng quên tắt khi ra mắt là lý do rất hay gặp khiến website mới không lên Google; các nguyên nhân khác có trong bài website bị mất index.
Cách kiểm tra robots.txt và noindex bằng Search Console
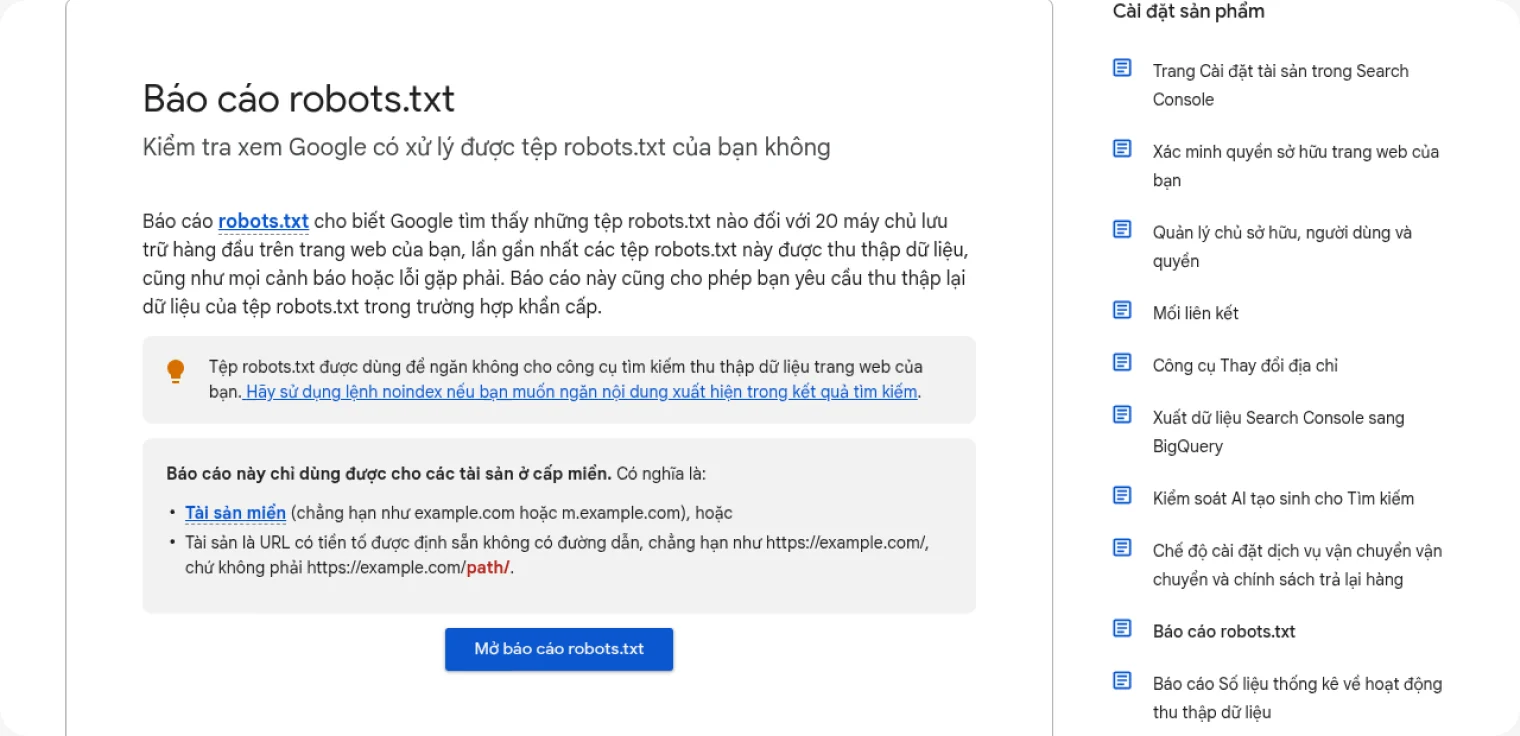
Cách kiểm tra robots.txt nhanh nhất là mở tenmien.vn/robots.txt trong cửa sổ ẩn danh xem nội dung có đúng ý không. Sau đó, bạn mở báo cáo robots.txt trong phần Cài đặt của Search Console: báo cáo cho biết Google tìm thấy tệp nào, lần tải gần nhất, các lỗi và cảnh báo, kèm nút yêu cầu thu thập lại khi bạn vừa sửa một lỗi nghiêm trọng.
Với từng trang cụ thể, công cụ Kiểm tra URL ở thanh trên cùng của Search Console cho biết trang có bị robots.txt chặn hay bị noindex loại trừ không. Ở mức toàn website, báo cáo Lập chỉ mục trang gom các trang chưa được lập chỉ mục theo lý do; hai lý do bạn nên xem đầu tiên là “Bị tệp robots.txt chặn” và trang có thẻ noindex. Nếu trong đó có trang dịch vụ hay sản phẩm quan trọng, đó là dấu hiệu chặn nhầm cần sửa ngay.
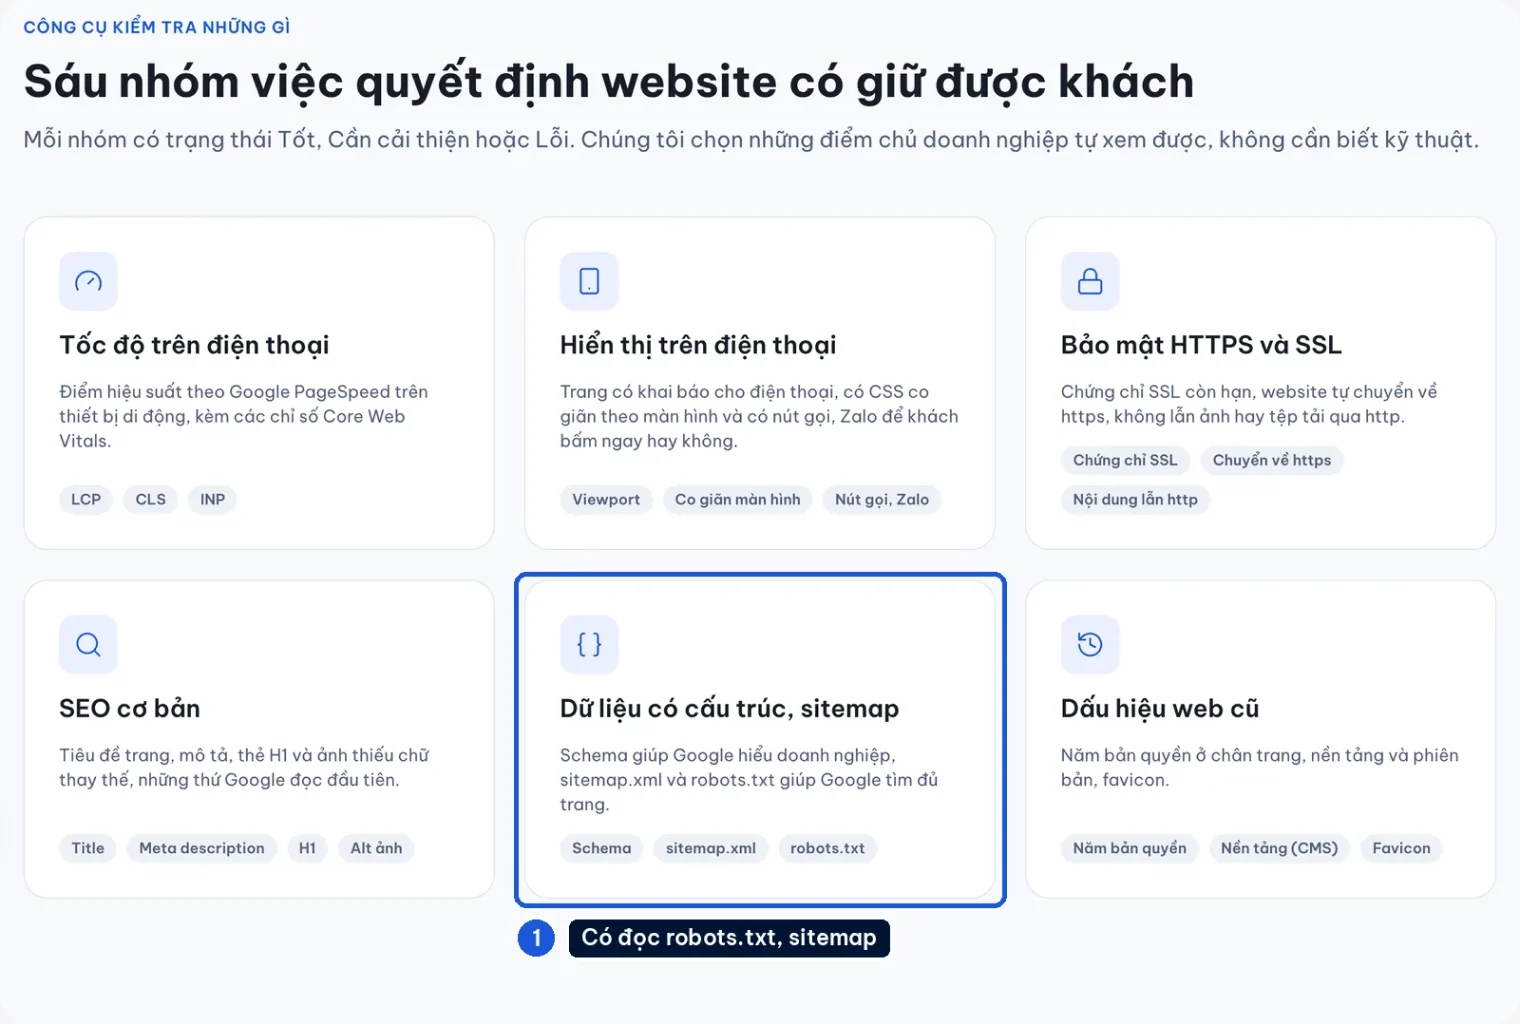
Nếu chưa quen Search Console, bạn có thể bắt đầu bằng công cụ kiểm tra website miễn phí của 123Website: nhập địa chỉ website, công cụ đọc sitemap.xml, robots.txt cùng tốc độ và các mục SEO cơ bản của trang chủ, rồi chỉ ra mục nào cần xem lại.
Sáu lỗi robots.txt và noindex hay gặp
Phần lớn lỗi không đến từ việc viết sai cú pháp mà từ việc quên dọn sau một lần thay đổi lớn. Sáu lỗi dưới đây là những lỗi chúng tôi hay thấy khi rà website doanh nghiệp, xếp theo mức độ ảnh hưởng.
Lỗi nặng nhất là còn sót Disallow: / từ bản dựng thử, một dòng chặn bot thu thập toàn bộ website. Lỗi thứ hai là quên bỏ chọn ô ngăn công cụ tìm kiếm trong WordPress sau khi ra mắt.
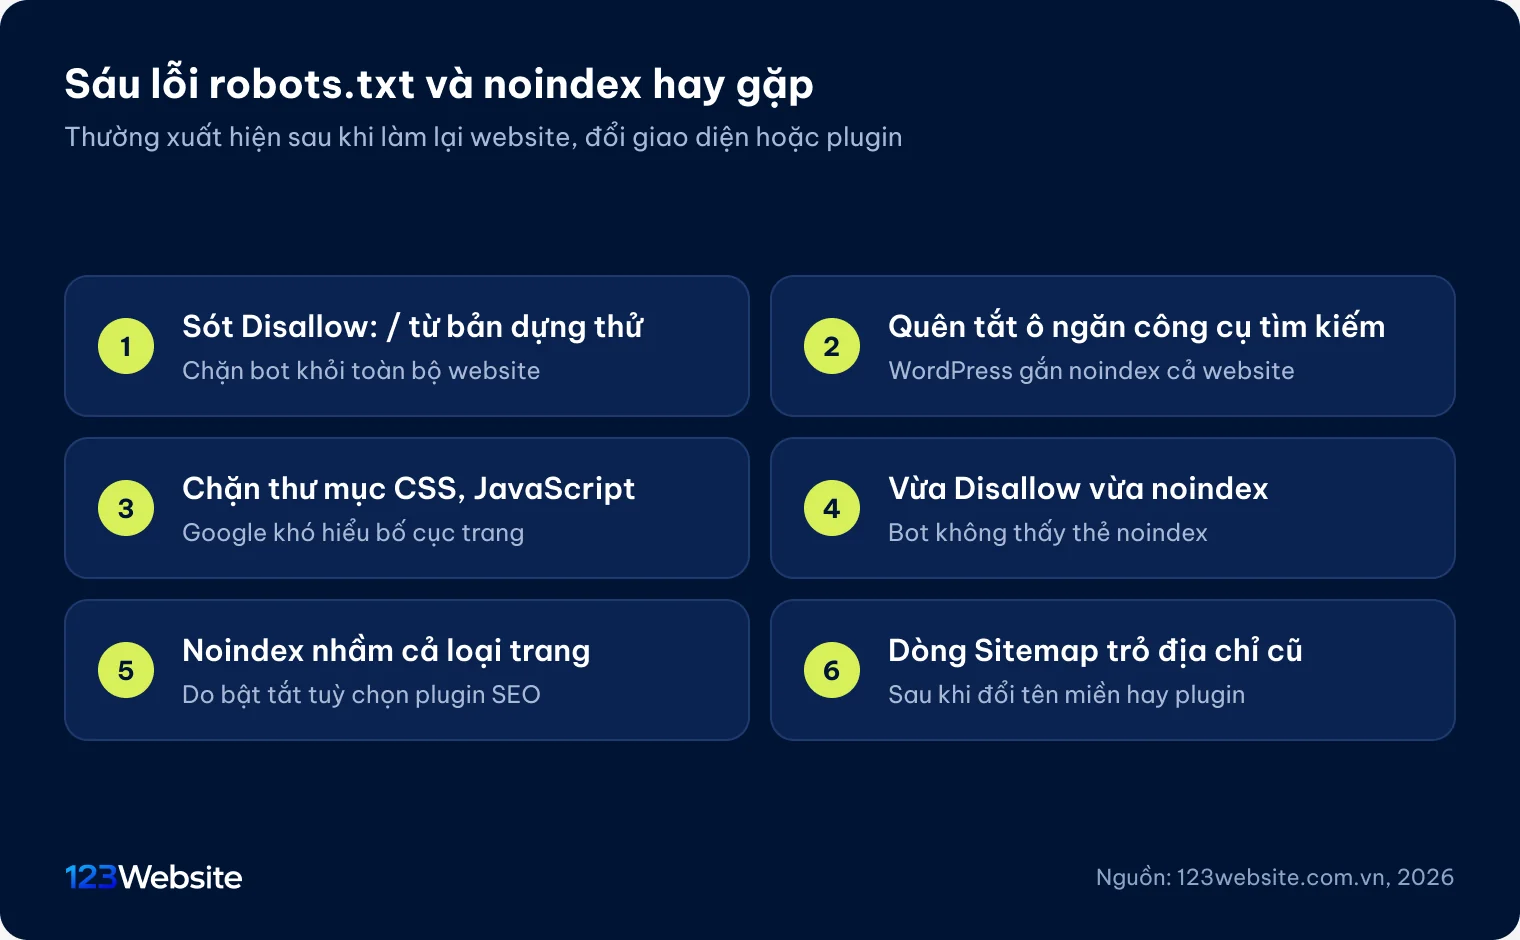
Bốn lỗi còn lại khó thấy hơn: chặn thư mục chứa CSS, JavaScript của giao diện, vừa chặn robots.txt vừa gắn noindex cho cùng một trang, gắn noindex nhầm cả một loại trang như toàn bộ danh mục sản phẩm khi bật tắt tuỳ chọn trong plugin, và cuối cùng là dòng Sitemap trỏ tới địa chỉ cũ sau khi đổi tên miền hay đổi plugin SEO.
Vì vậy, bạn nên rà robots.txt và các thẻ noindex mỗi khi làm lại website, đổi giao diện, cài plugin SEO mới hay chuyển hosting, cùng lúc với các việc trong checklist 30 ngày sau khi ra mắt hoặc buổi audit SEO định kỳ.
Có nên chặn bot AI bằng robots.txt?
Ngoài bot tìm kiếm, ngày càng nhiều bot AI ghé website để lấy nội dung. Việc chặn bot AI hay không tuỳ mục tiêu, và robots.txt là chỗ để khai báo bằng dòng User-agent mang tên từng bot. Bảng dưới đây tóm tắt bốn cái tên doanh nghiệp hay gặp và hệ quả khi chặn.
| Tên trong User-agent | Của ai | Chặn thì ảnh hưởng gì |
|---|---|---|
| Googlebot | Website dần biến khỏi Google Tìm kiếm, gần như không bao giờ nên chặn | |
| Google-Extended | Không ảnh hưởng Tìm kiếm, chỉ ngừng dùng nội dung cho các mô hình Gemini | |
| GPTBot | OpenAI | Nội dung không được dùng để huấn luyện mô hình |
| OAI-SearchBot | OpenAI | Website khó hiện trong kết quả tìm kiếm của ChatGPT |
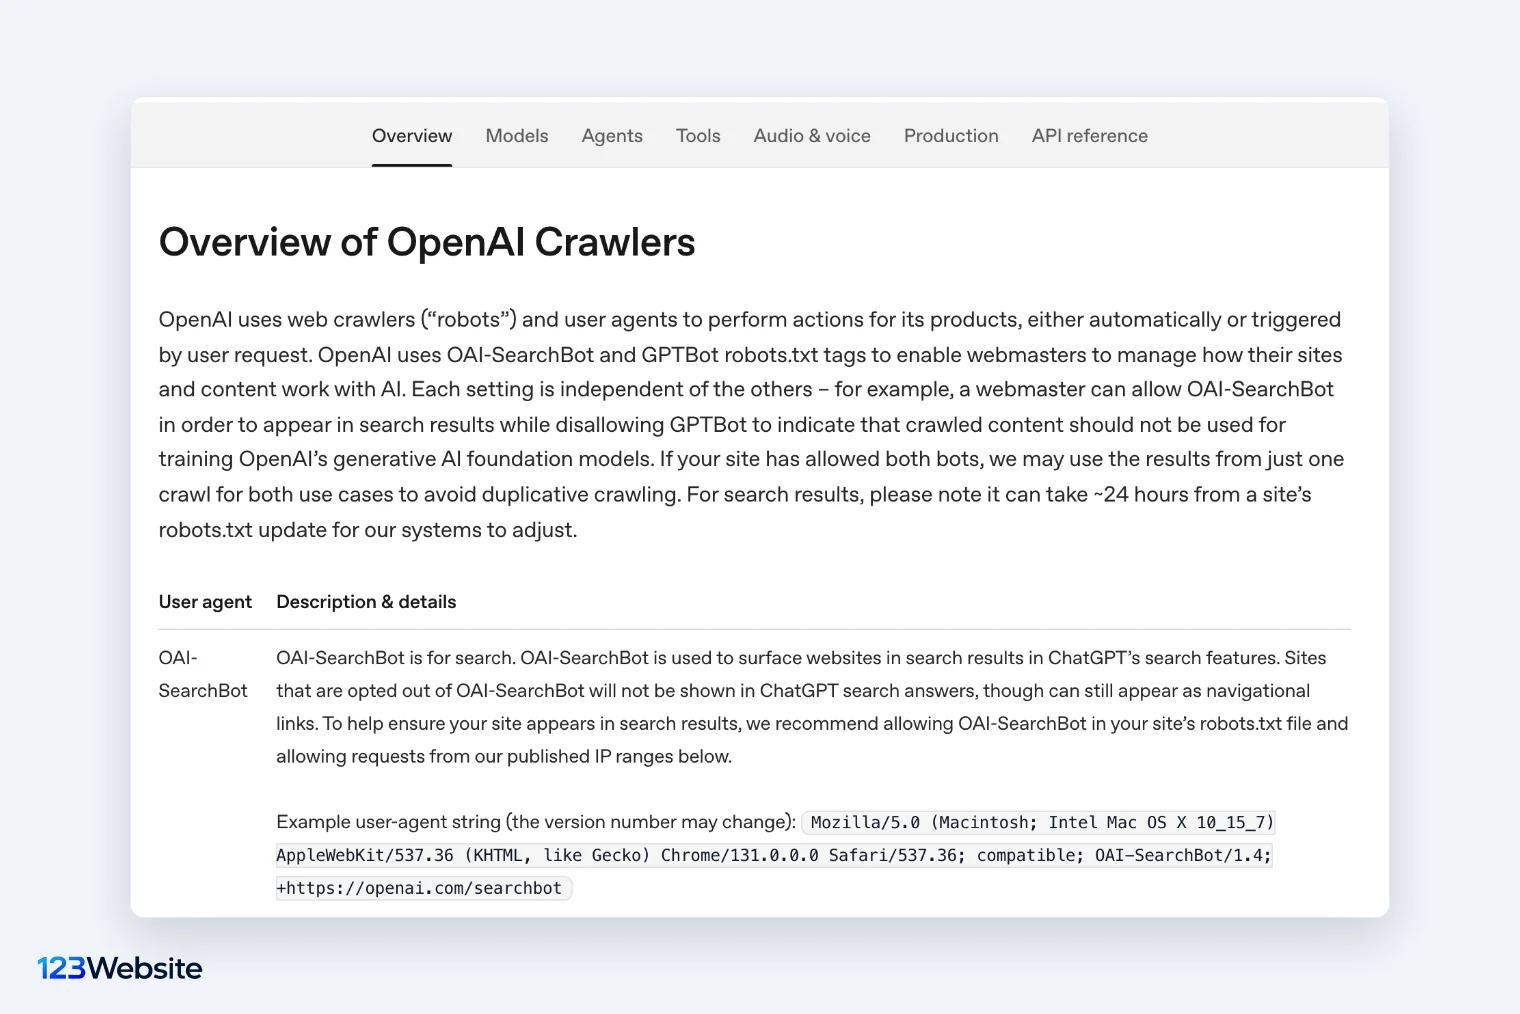
OpenAI tách riêng các bot: GPTBot dùng cho việc huấn luyện mô hình, còn OAI-SearchBot dùng để hiện website trong kết quả tìm kiếm của ChatGPT. Nếu muốn được AI trích dẫn và dẫn khách về, bạn đừng chặn bot tìm kiếm của họ; cách chuẩn bị nội dung để AI hiểu đúng có trong bài tối ưu website cho AI.
Nhờ 123Website rà robots.txt và lỗi index
Nếu website đang có trang quan trọng không lên Google hoặc trang lẽ ra phải ẩn lại hiện ra, dịch vụ SEO của 123Website nhận audit miễn phí trước khi báo giá, gói SEO theo dự án từ 9.900.000 đ có phần xử lý lỗi index. Với việc nhỏ như sửa vài dòng robots.txt hay gỡ noindex nhầm, gói kỹ thuật viên theo giờ từ 300.000 đ mỗi tuần (KTV1) là đủ.
Nếu đang chuẩn bị làm website mới, website theo mẫu tại 123Website có giá từ 4,99 triệu (gói GOLD) theo bảng phí thiết kế website, và bạn có thể dặn trước để robots.txt, sitemap cùng thẻ noindex cho trang cảm ơn được cài đúng ngay từ ngày ra mắt.
Câu hỏi thường gặp
Website có bắt buộc phải có robots.txt không?
Không bắt buộc. Theo Google, khi tệp robots.txt trả lỗi 404, Google coi như không có giới hạn nào và được thu thập mọi trang. WordPress cũng tự tạo một tệp ảo cơ bản. Bạn chỉ cần tệp riêng khi muốn chặn khu vực nhất định hoặc khai báo sitemap.
Sửa robots.txt bao lâu thì Google cập nhật?
Google thường lưu bản robots.txt trong bộ nhớ đệm tối đa 24 giờ, nên thay đổi có thể mất khoảng một ngày mới có tác dụng. Trường hợp gấp, như lỡ chặn cả website, bạn yêu cầu thu thập lại tệp trong báo cáo robots.txt của Search Console.
Gắn noindex rồi bao lâu trang biến khỏi Google?
Phải chờ Google thu thập lại trang. Trang quan trọng có thể chỉ vài ngày, trang ít được ghé có thể lâu hơn nhiều. Muốn nhanh hơn, bạn dùng công cụ Kiểm tra URL trong Search Console để yêu cầu thu thập lại trang đó.
Noindex có làm giảm thứ hạng các trang khác không?
Không. Noindex chỉ tác động lên trang được gắn. Loại bớt trang mỏng, trùng lặp khỏi kết quả còn giúp người tìm gặp đúng những trang có giá trị hơn. Điều cần cẩn thận duy nhất là không gắn nhầm vào trang dịch vụ, sản phẩm hay bài viết.
Noindex và nofollow khác nhau thế nào?
Noindex báo không đưa trang vào kết quả tìm kiếm, còn nofollow là gợi ý không theo các link trên trang hoặc một link cụ thể. Hai quy tắc có thể dùng cùng nhau, nhưng phần lớn trường hợp chỉ cần noindex là đủ.
Vài dòng nhỏ, nên rà định kỳ
Robots.txt là gì, gọn lại là tấm biển chỉ đường cho bot, còn noindex là lời dặn trang nào không lên Google. Cần người xem giúp, bạn gọi 0932 092 002 trong giờ làm việc hoặc để lại thông tin ở trang đăng ký tư vấn.
Jollie là chuyên gia trong lĩnh vực số hóa doanh nghiệp, tư vấn xây dựng giải pháp số và phần mềm quản trị phù hợp cho từng giai đoạn phát triển của doanh nghiệp. Với hơn 5 năm kinh nghiệm triển khai marketing online cho…